Uma IA que responde uma pergunta pode errar e produzir uma resposta ruim. Uma IA que age dentro de um sistema pode errar e cancelar um pagamento, alterar um cadastro, disparar uma mensagem para a base errada ou abrir uma solicitação que ninguém aprovou.
Essa é a diferença entre usar IA como interface e usar IA como parte da operação.
Nos últimos dias, empresas de segurança passaram a tratar esse segundo cenário como uma categoria própria. A Cisco anunciou recursos de red teaming e observabilidade para agentes. A CrowdStrike apresentou um mecanismo de interrupção e controle para ações de IA. O recado por trás das novidades é simples: quando um modelo ganha ferramentas, permissões e capacidade de executar, ele precisa ganhar também limites técnicos.
A pergunta certa não é se a empresa deve usar agentes. É esta:
quem consegue interromper a IA quando a execução sai do previsto?
Um agente não é apenas um modelo
Uma LLM, ou Large Language Model, é um modelo que interpreta contexto e produz texto, código ou uma decisão provável. Ela não é, por si só, uma aplicação com autoridade para mudar um sistema.
O agente aparece quando essa capacidade de raciocínio é conectada a um conjunto de ferramentas. Ele pode buscar um cliente, consultar estoque, montar um relatório, criar uma tarefa, enviar uma mensagem ou chamar uma API.
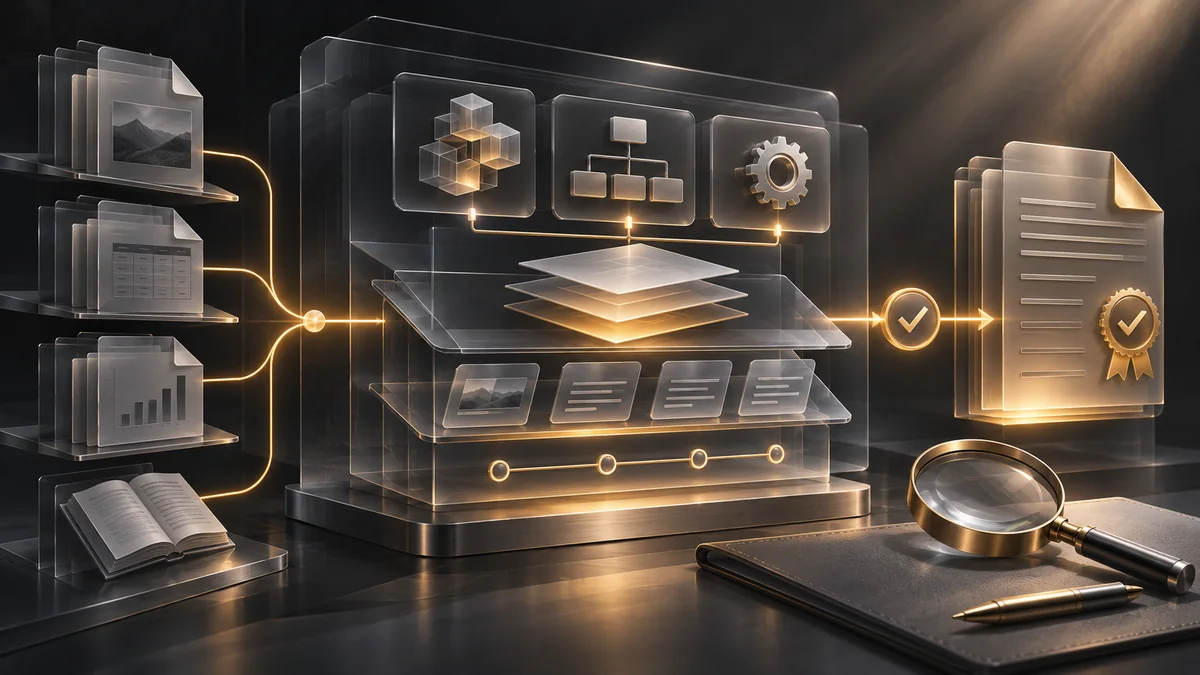
Na prática, um agente em produção reúne pelo menos cinco camadas:
- modelo: interpreta o pedido e propõe um caminho;
- orquestrador: organiza etapas, memória, regras de execução e tentativas;
- ferramentas: são as funções e APIs que permitem agir;
- identidade e permissões: definem o que cada agente pode acessar;
- observabilidade: registra o que aconteceu e permite investigar.
O modelo trabalha com probabilidade. A ferramenta, porém, executa uma ação determinística. Se o agente chama cancelar_pagamento(id), o sistema não interpreta intenção: ele cancela ou bloqueia.
Por isso, uma boa arquitetura separa duas coisas que frequentemente são misturadas: a IA pode propor uma ação; a aplicação precisa autorizar essa ação.
Kill switch não é um botão vermelho
O termo kill switch parece dramático, mas descreve uma necessidade bem prática: interromper a capacidade de execução antes que um comportamento inesperado vire impacto operacional.
Em um sistema real, isso não deveria ser apenas um botão na tela. Precisa ser um conjunto de controles capazes de:
- interromper execuções agendadas e novas chamadas;
- cancelar tarefas que aguardam em uma fila;
- revogar tokens temporários e credenciais de sessão;
- bloquear uma ferramenta específica sem derrubar o sistema inteiro;
- registrar o estado da execução para análise posterior;
- devolver o processo a um caminho manual quando necessário.
O detalhe importante é que a interrupção deve ocorrer fora do modelo. Pedir para a própria IA "pare de agir" é uma instrução. Revogar a permissão dela para chamar uma API é um controle.
Essa diferença é a mesma que existe entre esconder um botão no navegador e validar a permissão no servidor. A interface pode orientar o uso. A regra que protege a operação precisa estar onde a execução acontece.
Menor privilégio também vale para IA
O princípio do menor privilégio diz que uma identidade deve receber apenas o acesso necessário para cumprir sua função. Não é uma regra nova de cibersegurança. O que mudou é que agora o agente também precisa ter uma identidade própria.
Um agente que responde dúvidas de clientes não precisa ter acesso ao financeiro. Um agente que gera rascunhos de relatório não deve editar dados de produção. Um agente que cria tarefas não precisa apagar projetos.
Na prática, isso pede decisões arquiteturais claras:
- contas de serviço separadas para cada agente;
- tokens de curta duração e escopo limitado;
- ferramentas pequenas, específicas e verificáveis;
- políticas escritas em código, antes da chamada à API;
- isolamento entre ambiente de teste e produção;
- limites de volume, valor financeiro e repetição de tentativas.
Em vez de entregar executar_sql(query) a um agente, é mais seguro oferecer funções como listar_pedidos_em_atraso() ou criar_solicitacao_de_compra(dados). A segunda opção reduz o espaço de ações possíveis e deixa a intenção auditável.
Nem toda ação merece a mesma autonomia
Autonomia não é uma escolha binária. Ela pode variar conforme o impacto da decisão.
Uma classificação simples ajuda a desenhar o fluxo:
- Consulta: o agente lê dados e responde. Não altera nada.
- Ação reversível: cria uma tarefa ou prepara um rascunho, com possibilidade de correção.
- Ação sensível: atualiza um cadastro relevante, envia comunicação externa ou movimenta uma fila. Exige regra adicional e registro.
- Ação crítica: aprova pagamento, exclui dados, altera permissão ou fecha um contrato. Exige aprovação humana e autenticação reforçada.
É aqui que entram dois termos úteis. Human in the loop significa que uma pessoa aprova antes de a ação ser executada. Human on the loop significa que a IA executa dentro de limites, enquanto uma pessoa acompanha, recebe alertas e pode intervir.
O primeiro faz sentido para decisões de alto impacto. O segundo pode ser adequado para ações repetitivas, reversíveis e bem delimitadas.
Observabilidade é mais do que saber se funcionou
Em software, observabilidade é a capacidade de entender o comportamento interno de um sistema a partir de seus registros, métricas e rastros. Para agentes de IA, isso não se resume a guardar a resposta final.
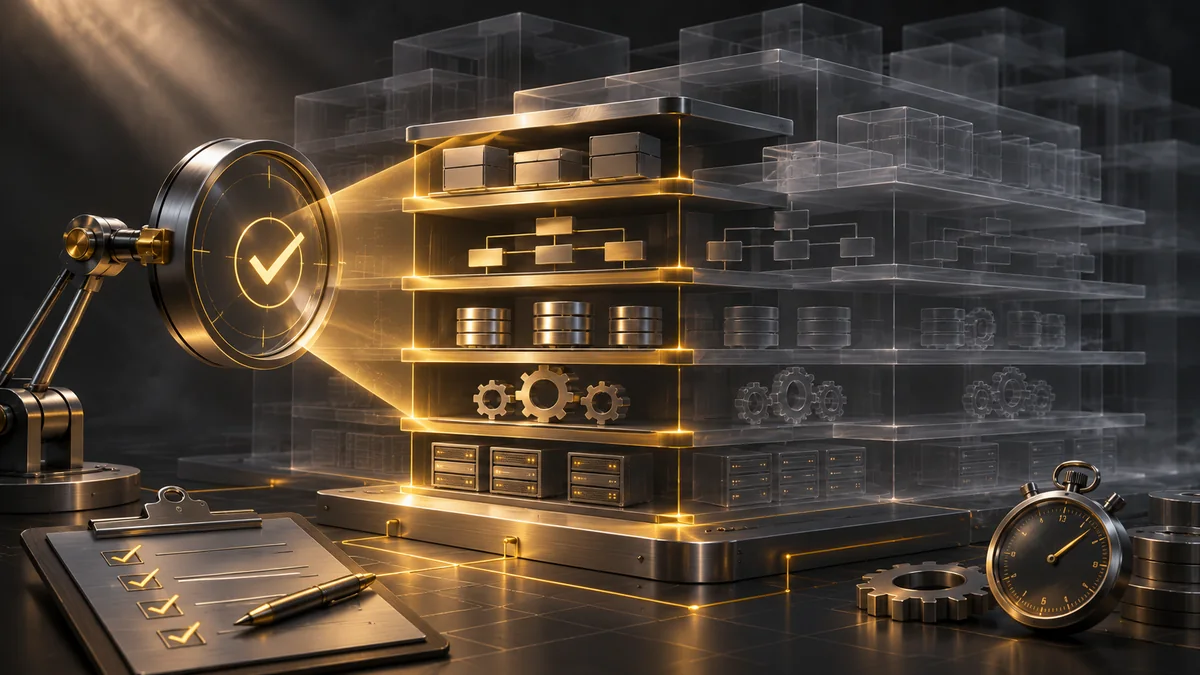
Uma execução precisa registrar, de maneira protegida e proporcional:
- qual objetivo foi solicitado;
- qual contexto e quais dados foram usados;
- quais ferramentas foram chamadas e com quais parâmetros;
- quais políticas permitiram, bloquearam ou pediram aprovação;
- quanto tempo, custo e tentativas a tarefa consumiu;
- qual identidade autorizou a ação;
- qual resultado foi devolvido pela ferramenta.
Esses dados ajudam a descobrir se um agente falhou, repetiu uma tarefa, recebeu uma instrução maliciosa ou tentou uma ação fora do seu escopo. Também permitem melhorar o processo sem depender de impressão ou memória de quem acompanhou o caso.
Há um cuidado necessário: observar não significa armazenar tudo sem critério. Prompts, documentos e respostas podem conter dados pessoais ou informações estratégicas. A trilha de auditoria precisa seguir retenção, mascaramento, controle de acesso e LGPD.
O teste real começa antes da produção
Antes de liberar um agente, a empresa precisa testá-lo como testaria qualquer parte exposta da operação. Isso inclui simular situações que não aparecem na demonstração:
- instruções contraditórias ou escondidas em documentos;
- tentativa de induzir o agente a ignorar uma política;
- dados incompletos, duplicados ou desatualizados;
- falha de API e reexecução indevida;
- eventos repetidos que causam ações duplicadas;
- tentativa de sair do escopo de permissão;
- volume anormal de requisições ou custo fora do esperado.
Esse exercício é chamado de red teaming. Em vez de esperar que alguém encontre uma falha na operação, a própria empresa tenta provocar o desvio em ambiente controlado. O objetivo não é provar que a IA é perfeita. É descobrir onde o sistema precisa de uma barreira, aprovação ou regra melhor.
A autonomia precisa de dono
Agentes podem reduzir trabalho repetitivo, responder mais rápido e preparar decisões com mais contexto. Esse valor aparece quando a IA é colocada perto do processo real, não quando recebe acesso ilimitado a tudo.
Antes de delegar uma ação a um agente, vale responder três perguntas:
quais decisões ele pode apoiar, quais ações ele pode executar e quem consegue interrompê-lo?
A IA pode ser autônoma. A responsabilidade não.
Comentários
Nenhum comentário ainda. Comece a conversa.