
Durante muito tempo, segurança foi tratada como a última etapa do desenvolvimento. O sistema ficava pronto, alguém rodava uma ferramenta, fazia alguns testes e, se nada muito grave aparecesse, a aplicação seguia para produção.
Esse modelo já não acompanha a realidade.
Hoje, sistemas mudam o tempo todo. Novas funcionalidades entram toda semana, dependências externas são atualizadas, APIs se conectam a serviços de terceiros e a infraestrutura roda em ambientes cada vez mais distribuídos. Nesse cenário, testar segurança só no final é como instalar alarme depois que a porta já ficou aberta por meses.
Com inteligência artificial, esse contexto fica ainda mais sensível.
IA acelera desenvolvimento, documentação, análise de código, testes e automações. Mas também acelera erro. Um trecho inseguro pode ser gerado mais rápido. Uma dependência vulnerável pode ser sugerida com naturalidade. Um agente pode executar ações no pipeline, chamar APIs, ler arquivos, interpretar falhas e tentar caminhos alternativos dentro das permissões que recebeu.
Por isso, cibersegurança precisa entrar no ciclo de desenvolvimento desde o começo.
Não é sobre procurar falhas apenas quando o sistema está pronto. É sobre criar um processo capaz de impedir que vulnerabilidades conhecidas entrem no código, detectar riscos rapidamente e validar se os controles continuam funcionando depois da publicação.
Esse é o princípio do DevSecOps: desenvolvimento, segurança e operações trabalhando juntos. A segurança deixa de ser uma barreira no fim do projeto e passa a ser uma disciplina contínua dentro da engenharia.
Pentest é importante, mas não é processo
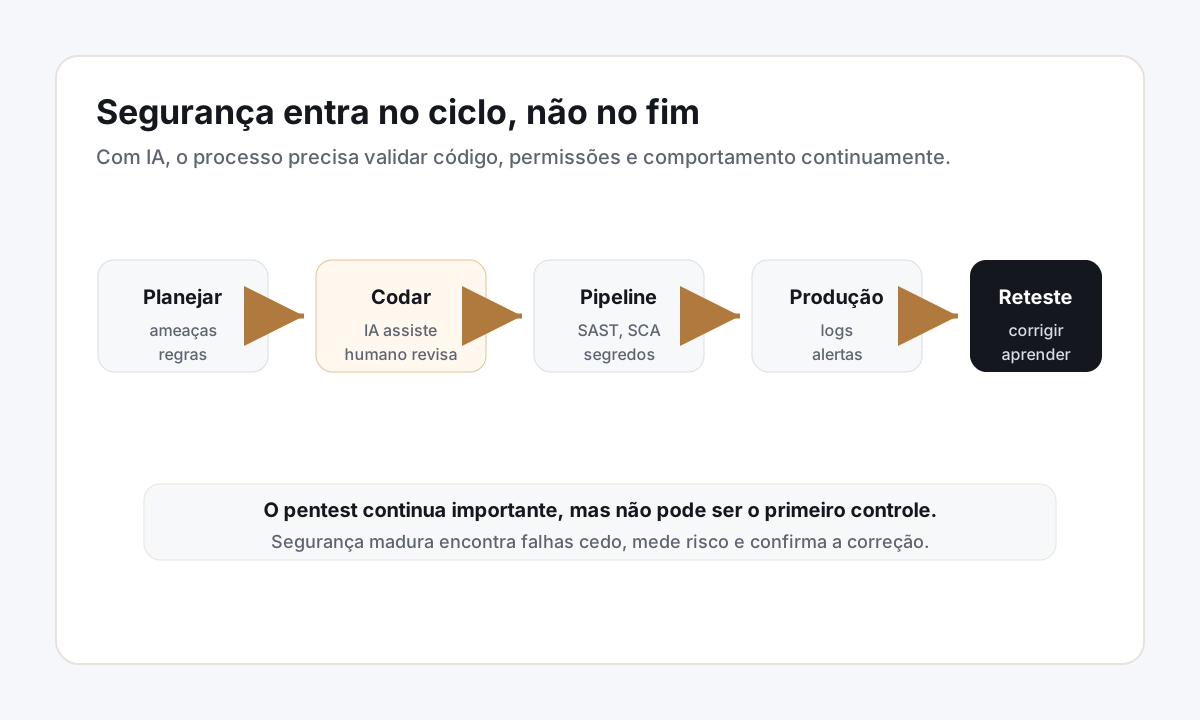
Na prática, isso começa com uma mudança simples: segurança não pode depender apenas de pentest anual.
O pentest, ou teste de invasão, continua sendo importante. Ele simula ataques reais, identifica falhas de lógica, testa permissões, valida impactos e encontra problemas que ferramentas automáticas nem sempre enxergam. Mas ele não deve ser o único controle.
Um programa maduro combina várias camadas.
A primeira é o shift left, que significa antecipar os testes de segurança para as fases iniciais do desenvolvimento. Em vez de descobrir uma falha crítica na véspera do lançamento, a equipe identifica o problema ainda no código, no pull request ou na arquitetura.
Depois vem a segurança contínua no pipeline. A cada alteração relevante, o sistema pode executar verificações automáticas: busca por segredos, análise de código, verificação de dependências, testes de autorização e análise de infraestrutura.
Também existe o shift right, que olha para o sistema depois que ele está em produção. Porque segurança não termina no deploy. É preciso monitorar erros, acessos, tentativas suspeitas, comportamento anormal, exposição de serviços e novas vulnerabilidades que surgem com o tempo.
Com IA, esses três movimentos ficam mais importantes. O shift left revisa o que a IA ajudou a produzir. O pipeline controla o que a automação tenta publicar. O shift right observa se um comportamento novo, humano ou automatizado, saiu do padrão esperado.
Como a IA muda o contexto de segurança
A IA muda o contexto porque ela entra em duas pontas ao mesmo tempo.
Do lado de quem constrói, ela acelera produção de código, scripts, consultas, testes, documentação e integrações. Isso aumenta produtividade, mas também reduz o intervalo entre ideia e deploy. Se o processo de revisão for fraco, a empresa apenas entrega risco mais rápido.
Do lado de quem ataca, a IA também pode acelerar reconhecimento, leitura de mensagens de erro, criação de payloads, variação de tentativas, análise de APIs e busca por padrões conhecidos. Não é magia. É automação aplicada a etapas que antes eram mais lentas.
E existe uma terceira camada: os agentes de IA. Quando um agente deixa de apenas responder e passa a agir, ele vira parte da superfície de ataque. Se ele acessa repositórios, tickets, arquivos, banco de dados, ambientes de teste, ferramentas de deploy ou serviços externos, suas permissões precisam ser tratadas com a mesma seriedade de qualquer identidade técnica.
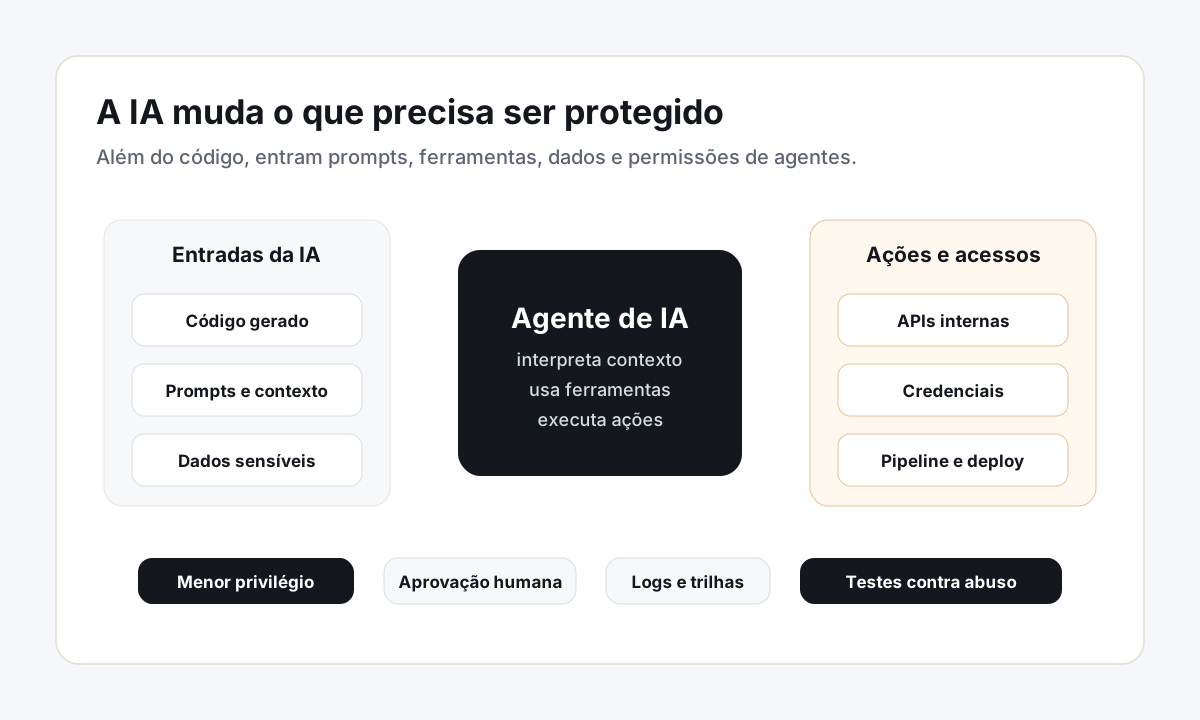
Isso não significa evitar IA. Significa governar o uso.
Uma empresa pode usar IA para revisar código, sugerir testes, resumir alertas, classificar vulnerabilidades e apoiar análise de logs. Mas precisa definir limites: quais dados podem ser enviados, quais ferramentas podem ser acionadas, quais ações exigem aprovação humana e quais registros precisam ficar disponíveis para auditoria.
IA sem processo vira atalho. IA com processo vira capacidade.
Os testes que precisam entrar no fluxo
Alguns testes são fundamentais nesse processo.
O SAST, ou Static Application Security Testing, analisa o código sem executar a aplicação. Ele ajuda a encontrar uso inseguro de funções, consultas vulneráveis, falhas de validação, credenciais expostas, criptografia inadequada e possíveis pontos de injeção.
O SCA, ou Software Composition Analysis, olha para as dependências. Isso é essencial porque aplicações modernas usam dezenas, centenas ou até milhares de pacotes externos. Às vezes, o risco não está no código escrito pela equipe, mas em uma biblioteca desatualizada, abandonada ou vulnerável.
Outro controle importante é a detecção de segredos. Tokens, senhas, chaves privadas, arquivos .env e credenciais de nuvem nunca deveriam estar no repositório. E quando aparecem, não basta apagar. A credencial deve ser considerada comprometida e precisa ser revogada ou rotacionada.
Já o DAST, ou Dynamic Application Security Testing, testa a aplicação em execução. Ele interage com rotas, formulários, APIs, parâmetros e cabeçalhos para identificar comportamentos inseguros, como falhas de sessão, exposição de arquivos, erros detalhados demais, ausência de cabeçalhos de segurança e endpoints indevidos.
No contexto de IA, entram testes adicionais: tentativa de prompt injection, vazamento de dados sensíveis, uso indevido de ferramentas, execução de ações fora do escopo, acesso a arquivos não autorizados e falhas de isolamento entre usuários, clientes ou ambientes.
Quando a IA participa do desenvolvimento, também vale revisar o que ela sugere. Código gerado não deve entrar como exceção ao processo. Deve passar por revisão, testes, análise de dependências e validação de arquitetura como qualquer outro código.
Nem tudo pode ser automatizado
Ferramentas ajudam, mas não entendem tudo.
Falhas de lógica de negócio exigem contexto humano. Um scanner pode não entender que um usuário não deveria aprovar a própria solicitação, aplicar o mesmo desconto várias vezes, alterar um pedido depois da aprovação ou acessar dados de outra empresa.
Esse tipo de risco aparece quando alguém entende o processo e pensa como atacante.
Por isso, segurança boa combina ferramenta e método.
Antes de testar, é preciso entender o que pode ser atacado. Esse trabalho se chama modelagem de ameaças. A equipe identifica ativos importantes, tipos de usuário, permissões, pontos de entrada, integrações externas, dados sensíveis, agentes de IA, ferramentas conectadas e cenários de abuso.
Perguntas simples já revelam muito:
- Quem pode acessar essa funcionalidade?
- Um usuário consegue ver dados de outro?
- Essa operação pode ser repetida sem limite?
- O sistema valida a regra no servidor ou só esconde o botão na tela?
- A ação deixa registro suficiente para auditoria?
- Um agente de IA consegue acionar essa operação sem aprovação?
- O prompt ou o log pode expor informação sensível?
Essas respostas viram testes.
Autorização e APIs continuam no centro
Em sistemas empresariais, uma das áreas mais críticas é a autorização. Não basta saber se o usuário está logado. É preciso saber exatamente o que ele pode fazer. Usuário comum, gestor, administrador e agente técnico devem ter permissões claras.
E essas permissões precisam ser testadas no backend, não apenas no frontend.
Esconder um botão não é segurança.
Segurança é impedir a ação no servidor.
Outro ponto sensível são as APIs. Muitas falhas graves acontecem quando uma API permite trocar um identificador, acessar dados de outro cliente, alterar propriedades que não deveriam ser alteradas ou consultar informações sensíveis sem validação adequada.
Por isso, APIs precisam de testes específicos: autenticação, autorização, limites de requisição, exposição de dados, alteração de métodos, paginação abusiva, upload de arquivos e manipulação de parâmetros.
Com IA, esse cuidado aumenta. Agentes e automações costumam interagir com APIs diretamente. Se a API não valida regra no servidor, a automação pode executar uma ação que a interface jamais mostraria ao usuário.
Infraestrutura também é código
A infraestrutura também entra na conta.
Uma aplicação bem escrita pode ser comprometida por uma implantação mal configurada. Portas abertas, serviços expostos, credenciais padrão, modo debug ativo, buckets públicos, containers desatualizados, backups acessíveis e permissões excessivas são portas que não deveriam estar abertas.
Como infraestrutura é cada vez mais declarada em código, ela também precisa entrar no pipeline de segurança: análise de arquivos de infraestrutura, validação de imagens, revisão de permissões, política de segredos, segmentação de ambientes e monitoramento contínuo.
Se a IA cria scripts de deploy, sugere configurações ou opera ferramentas internas, esses artefatos precisam passar pelo mesmo filtro.
Vulnerabilidade não pode virar relatório esquecido
No fim, cibersegurança aplicada ao desenvolvimento não é um evento. É um ciclo.
Um fluxo básico poderia funcionar assim: a cada commit, verificar segredos. A cada pull request, rodar SAST e análise de dependências. No build, validar imagem e infraestrutura. Em homologação, executar testes dinâmicos, testes de autorização e testes específicos de IA quando houver agentes ou modelos conectados. Antes de releases importantes, fazer varredura completa, modelagem de ameaças e pentest manual. Depois da correção, retestar.
E tudo precisa ser rastreável.
Cada vulnerabilidade deve ter responsável, severidade, evidência, impacto, prazo, status e reteste. Sem gestão, vulnerabilidade vira relatório esquecido. Com gestão, vira item de trabalho até ser corrigido, aceito formalmente ou descartado como falso positivo.
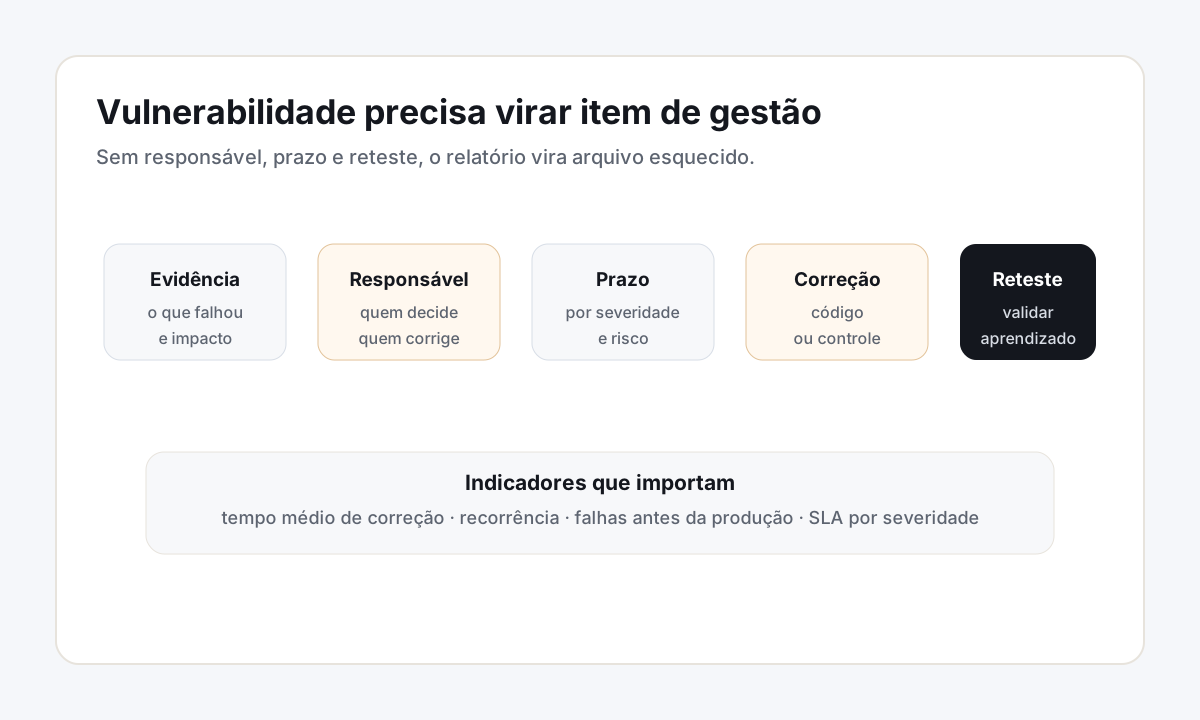
A maturidade aparece nos indicadores: tempo médio de correção, falhas por severidade, vulnerabilidades recorrentes, percentual corrigido dentro do prazo, dependências vulneráveis, falhas encontradas antes da produção e falhas encontradas em produção.
A métrica mais importante não é quantas vulnerabilidades foram encontradas. É quantas deixaram de voltar.
Porque corrigir uma falha é necessário. Mas aprender com ela é o que melhora o sistema.
Segurança é método, evidência e responsabilidade
Segurança de software não promete um produto "100% seguro". Essa promessa não é realista.
O que ela entrega é algo mais sério: um processo verificável, contínuo e orientado a risco.
No contexto atual, esse processo precisa incluir IA. Não como ameaça inevitável, nem como solução mágica. IA é capacidade. E toda capacidade nova precisa de limite, rastreabilidade, revisão e governança.
Um sistema seguro não nasce de uma ferramenta isolada.
Não nasce de um pentest no fim.
Não nasce de sorte.
Nasce de método, evidência, disciplina e responsabilidade desde a primeira linha de código até a operação em produção.
Comentários
Nenhum comentário ainda. Comece a conversa.